بســم الله الـرحمــن الرحيــم
1. بنية أنظمة الويندوز Windows Architecture:
فهم البنية التحتية لأنظمه الويندوز مطلب ضروري لأي مبرمج يريد بناء برامج تعمل بكفائه عالية على نظام ويندوز وفي هذه السلسله من الدروس سوف نتناول أساسيات البرمجه تحت نظام الويندوز سواء انشاء واستخدام الProcess/Thread وMemory Management الى التعامل مع الDLL والSEH . وقبل الدخول في تفاصيل كيف يعمل نظام ويندوز نقوم بعرض مراحل تطور النظام وميزاته الأساسية.
1.1. Brief History and Features:
أنظمه الويندوز تقسم الى قسمين أساسين الأول وهو Windows NT (ويشمل Windows Server 2003,2000,XP) والثاني وهو Window 9x (ويشمل Windows ME,98,95,16 bit versions). صمم الNT من البداية ليكون 32 بت ويدعم الذاكرة الظاهرية Virtual Memory ويدعم تعدد المسارات Multithreading وتعددية المعالجات Multiprocessors مما جعله مناسب لأغلب البرامج والأجهزه الحديثة .
كل من هذين النظامين متوافقين مع Win32 API لكتابة برامج تعمل على النظامين ومنذ 2001 توقف مايكروسوفت عن دعم 9x وأصبحت تتعامل مع ال NT-Based System . وأحد أفضل نسخ الNT التي أنتجتها مايكروسوفت هي Windows XP والتي سيكون عليها محور الحديث في هذا الفصل والقادم ولكن بما أن جميع الأنظمه مايكروسوفت الحديثه هي نسخ NT فالمفاهيم التي سندرسها الأن تنطبق عليها .
تميزت أنظمه Windows NT بأنها نسخ 32 بت 32-bit Architecture وحالياً وبدءً من أخر أصدار لويندوز 7 فلن تكون هناك نسخ 32 بت بعد ذلك، وكل النسخ سوف تكون 64 بت. حاليا تتوفر نسخ NT لل64 بت . ميزة أخرى وهي دعم الVirtual Memory وسوف نتحدث عنها فيما بعد . أيضا يتميز النظام بأنه يعمل على أكثر من منصة بعكس الإصدارات الأولى لويندوز حيث يمكن عمل اعادة ترجمته في المنصة لكي يعمل عليها. والتعامل مع الهاردوير يتم عبر طبقة Hardware abstract Layer والتي تعزل النظام من الهارديور وتسمح بنقل النظام لأي هارديور جديد.
أيضا يتميز النظام بأنه يدعم أسلوب الPreemptive في جدولة العمليات بالإضافة الى دعم الMultithreading .وبالرغم من أن أنظمه ويندوز القديمه كانت تدعم تعدد المسارات الا أنها كانت تستخدم أسلوب non-preemptive في بعض المكونات المكتوبة من نوع 16 بت مثل GDI و USER . ويتميز كيرنل NT بدعم أكثر من معالج وهذا يعني أنه مناسب لبيئات العمل التي تتطلب أداء عالي مثل Data-Center Server أو التطبيقات التي تستهلك المعالج.
وبعكس أنظمة ويندوز القديمة فNT بنى من الأساس لكي يكون أكثر أماناً Security فكل كائنا في النظام له محدد وصول Access Control List والذي تحدد المستخدم الذي يتعامل مع هذا الObject وحتى نظام الملفات NTFS يدعم ACL لكل ملف ويدعم التشفير لكل ملف أو القرص بالكامل. اضافة الى أن نظام NT متوافق Compatible مع التطبيقات القديمه ويستطيع تشغيل بعض تطبيقات ويندوز 16 بت أو تطبيقات الدوز وذلك من خلال تشغيها في بيئة تخيلية تكون معزولة عن النظام حتى لا تؤثر فيه. أخيرا فإن نظام NT مصمم من الأساس لكي يكون متعدد المنصات ولكي يعمل على أكثر من معمارية مثل IA-32,DE,ALPHA لكن النسخ الأخيره تدعم فقط IA-32 ولكنها تدعم المنصات المتوافقه مع انتل مثل AMD64.
1.2. التعامل مع الأخطاء Error Handling:
قبل التعرف على خصائص نظام الويندوز يجب فهم كيف تتعامل الدوال التي نقوم باستدعائها Win32 Function مع الأخطاء. فعندما يتم استدعاء دالة يتم التحقق من المعاملات المرسلة واذا كانت صحيحه القيم فيتم تنفيذ الدالة والا في حال لم تكن صحيحه أو لم تعمل لأي سبب من الأسباب فإن الدالة سوف ترجع قيمه تدل على الخطأ Error-Code . والجدول التالي يوضح القيم الراجعه في أغلب دوال الويندوز:

الشكل 1 يبين القيم الراجعه من أغلب دوال الويندوز
وعندما يحصل خطأ في الدالة تقوم الدالة باستخدام Thread Local Storage بوضع رقم الخطأ في الThread الذي قام باستدعاء الدالة وحصل بها الخطأ وبهذه الألية سوف يتم السماح لأكثر من Thread بالعمل دون أن يأثر رقم الخطأ الموجود في أحد الThread عن بقية الأرقام الموجوده في الThreads الأخرى في العملية.
عند حدوث الخطأ فأن الدالة ترجع رقم الخطأ Error Code ويمكن معرفة هذا الرقم من خلال الدالة GetLastError والتي لها التصريح التالي:
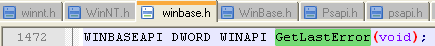
الشكل 2 يبين تصريح الدالة GetLastError
وترجع الدالة أخر خطأ حصل في الThread ، وبعد الحصول على رقم هذا الخطأ فمن المفيد تحويل هذا الرقم الى رسالة نصية توضح سبب الخطأ بشكل أكبر ، وتوجد جميع رسائل الخطأ والثوابت التي ترجعها الدالة GetLastError في ملف الرأس winerror.h والشكل 3 يبين مقطع صغير من ملف الرأس والذي يتكون من حوالى 3000 سطر في المترجم GCC بينما في الPSDK لمايكرسوفت فيبلغ حوالى 40000 سطر! والسبب في ذلك أن ملف الرأس في تطبيق مايكروسوفت يحتوي على الكثير من التعليقات بالإضافة الID للرسالة وماكرو مشابه للID .
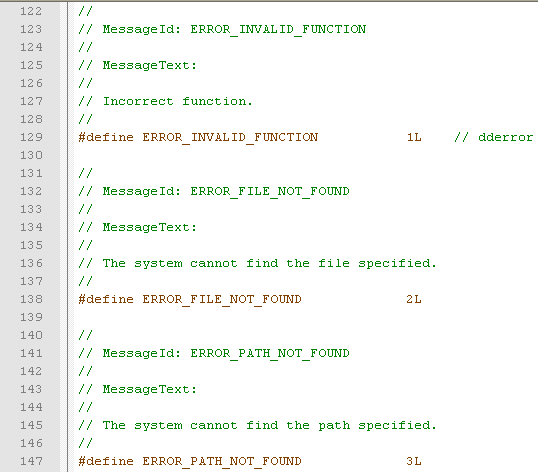
الشكل 3 يبين التعاريف في الملف winerror.h
وتوجد أداه تأتي مع الVisual Studio تسمى Error Lookup تستطيع من خلالها تحويل رقم الخطأ الى النص المقابل لرقم الخطأ والموجود في الشكل السابق باسم MessageText وهذا البرنامج يستخدم الدالة FormatMessage لتحويل رقم الخطأ الى الرسالة MessageText وللدالة FormatMessage التصريح التالي:
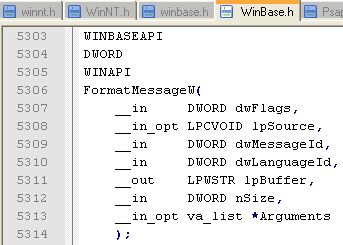
الشكل 4 يبين تصريح الدالة FormatMessageW
هذه الدالة من الدوال المفيده لاظهار النصوص للمستخدم حيث أنها تتعامل مع أكثر من لغه وتستقبل الدالة معرف اللغه Language ID كمعامل للدالة وترجع النص المناسب، وفيما يلي مثال لأداه command line تستخدم هذه الدالة وتعمل مثل عمل برنامج Error Lookup.
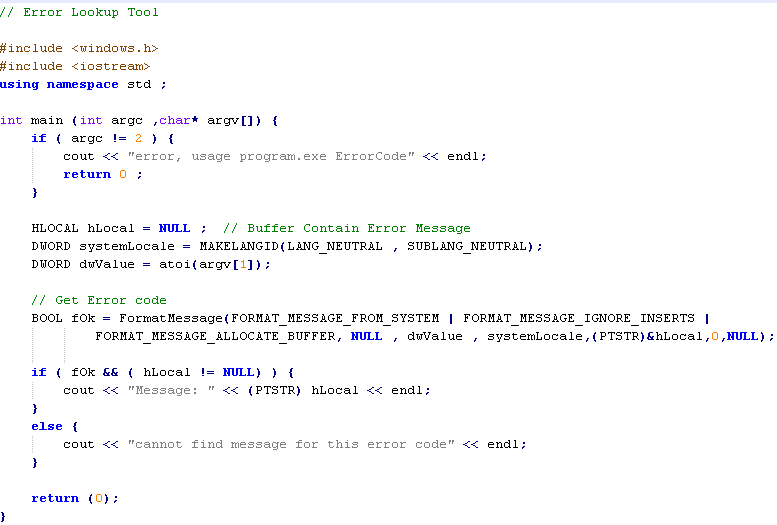
الشكل 5 يبين مثال على برنامج لمعرفه الخطأ Error Lookup
ويتم ارسال رقم الخطأ من خلال الargument للبرنامج كما في الشكل التالي:
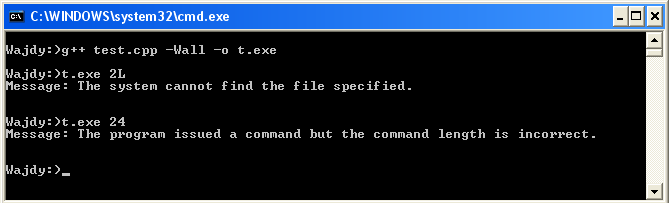
الشكل 6 يبين مخرج البرنامج السابق
1.3. Working with Characters and Strings:
بما أن نظام الويندوز يعد من أكثر الأنظمه انتشاراً حول العالم ويدعم أغلب اللغات المعروفة فيجب على المبرمجين كتابة برامج تدعم تلك اللغات لكي ينتشر التطبيق بشكل كبير في International Market. في السابق كان المبرمجين يكتبوا التطبيق باللغه الإنجليزية ثم يتم طرح دعم اللغات المختلفه مع الإصدارات التالية للبرنامج. وبالإستفادة من دعم النظام لأغلب اللغات فيمكن من البدايه كتابة البرنامج وجعله يدعم تلك اللغات المختلفة.
ومن المواضيع المهمه للغايه عند التعامل مع العمليات على النصوص هو تجنب الثغرات Buffer Overrun والتي تكون عادة عند التعامل مع النصوص. وأولت مايكروسوفت إهتماماً لهذا الأمر وقدمت مجموعه جديده من الدوال الأمنه والتي عند استخدامها ستحمي التطبيق من هذه الثغرات كما سيتبين ذلك لاحقاً.
المشكلة الحقيقية في موضوع الLocalization هو التعامل مع أبجديات مختلفة Character Sets ففي لغه السي نجد أن حجم المتغير من النوع char يبلغ واحد بايت (8 بت) وهو كافي لتمثيل جميع الحروف اللاتينية ولكن بعض اللغات مثل اليابانية تحتوي على الكثير من الأحرف في الأبجدية وهنا لن يكفى بايت واحد لمثيل كل هذه الحروف. ولحل هذه المشكلة تم تطوير أبجدية Double-Byte Character Sets (DBCS) وهي تمثل الحرف ببايت وحد أو 2 بايت. ففي اللغه اليابانية Kanji اذا كان الحرف الأول يقع في المدى من 0x81 الى 0x9F أو من المدى 0xE0 الى 0xFC فيجب النظر للبايت التالي لمعرفه الحرف (حيث يكون مكون من بايتين). والتعامل مع هذه النظام DBCS كان غير مريح للمبرمجين حيث بعض الأحرف تكون بحجم واحد بايت والأخرى بحجم 2 بايت ومن هنا كانت ولادة النظام اليونيكود Unicode (في عام 1988 بواسطة Apple و Xerox وبعدها انضمت بقية الشركات الكبرى في دعم هذا المقياس وتطويره مثل Oracle, IBM, Microsoft وغيرهم).
ونظام الويندوز يدعم اليونيكود سواء في داول الويندوز Win32 API أو في دوال مكتبة السي القياسية C Run-Time Library. ويستخدم النظام الترميز UTF-16 (وهو اختصار لUnicode Transformation Format) وهذا النظام UTF-16 يرمز كل حرف من خلال بايتين (16 بت) وهو كافي لمتثيل أغلب لغات العالم وبالتالي يسهل التعامل مع النصوص وحساب طولها عند العمل بهذا الترميز.
هناك ترميزات مختلفة من الUnicode منها الUTF-8 وهو يرمز الحرف الواحد بواحد أو 2 أو 3 أو 4 بايت! فالحروف التي هي أصغر من 0x0080 ترمز بواحد بايت (مثل أحرف اللغه الإنجليزي) والأحرف من 0x0080 الى 0x07FF ترمز ب2 بايت (مثل اللغات الأوروبية ولغات الشرق الأوسط Middle East) والأحرف من 0x0080 وما فوق ترمز ب3 بايت (مثل لغات الEast Asian) . وبعض الرموز ترمز من خلال 4 بايت. وبشكل عام نظام الUTF-8 استخدم كثيرا في السابق ولكنه أقل كفائه منUTF-16 في حال تم التعامل مع أحرف أكبر من 0x0080.
ترميز أخر وهو الUTF-32 وهو يرمز الحرف الواحد ب4 بايت وهو بالطبع يتعامل مع أي لغه ولكنه غير كفئ لأنه يستهلك الذاكرة (فلكل حرف 4 بايت) وبالتالي لا يستخدم هذه الترميز خصوصا في عمليات الحفظ Saving أو الإرسال عبر الشبكة بل يستخدم فقط من داخل البرنامج.
تقسم الينوكود القيم الى مناطق وكل منها تتعامل مع أبجدية مختلفة ، الجدول التالي يبين بعضا من المناطق والأبجديات المستخدمه فيها:
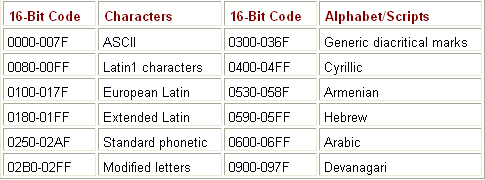
الشكل 7 يبين الأبجديات المختلفة في ترميز UTF-16
ANSI and Unicode Character and String Data Type 1.3.1 :
كل من تعامل مع لغة السي يعلم أن حجم المتغير من نوع الحرفي char هو 1 بايت وفي حال كتب الحروف داخل علامتي تنصيص Literal String فيقوم المترجم بتحويل كل حرف الى 1 بايت.

ولإستخدام الUTF-16 يتم استخدام النوع wchar_t ومترجمات مايكروسفت القديمه لا تدعم هذا النوع فعند استخدامه يتم كتابة المفتاح \Zc:wchar_t وهذا المفتاح يكون موجود تلقائياً في خيارات الترجمة عند عمل مشروع جديد في Visual Studio.
ويعرف النوع wchar_t على أنه unsigned short كما يوضحه الشكل التالي:
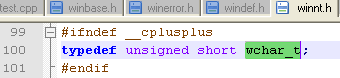
الشكل 8 يوضح تعريف المتغير wchar_t
الكود التالي يبين استخدام الينوكود في النصوص string والأحرف character باستخدم wchar_t :
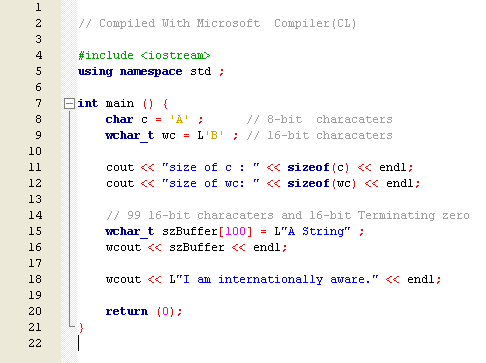
الشكل 9 يبين مثال للتعامل مع الANSI and Unicode Characters
استخدام الحرف الكبير L قبل أي Literal String يخبر المترجم بأن هذا النص يجب ترجمته على أنه Unicode وعندما يضع المترجم النص في قسم البيانات Data Section فهو يرمز كل حرف باستخدام UTF-16.
وقامت مايكروسوفت بتعريف أنواع متغيرات بأسماء مختلفه عن أنواع المتغيرات الموجودة في لغه السي لكي تفصل التعامل مع Win32 API قليلا عن الأنواع في لغه السي ، فمثلا في ملف الرأس WinNT.h نجد التعاريف التالية:
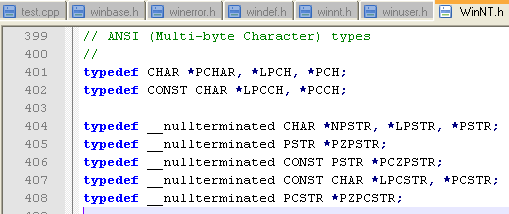
الشكل 10 يبين تعاريف الأنواع الأساسية في ملف WinNt.h
ونجد أيضا للWide Char هذه الأنواع :

الشكل 11 يبين تعاريف الأنواع الأساسية والتي تتعامل بالUnicode
بالنسبة __nullterminated فهي header annotation تصف كيف سيستخدم النوع سواء في المعاملات أو في القيم الراجعه وهي غير مهمه في أغلب الأحوال.
عند البرمجه بWin32 API يفضل استخدام هذه الأنواع بقدر الإمكان للتوافق أولا مع توثيق الMSDN وهذا يسهل قرائه الكود وصيانته. ومن الأفضل دائما كتابة كود عام بحيث يمكن أن يتترجم الى ANSI أو الى Unicode بدون أي تغيير. فلو نظرنا الى الملف WinNT.h مره أخرى سنجد أنه اذا كان يوجد تعريف للUnicode فسيتم تحويل Expand أي اسم TCHAR الى WCHAR (والذي هو في النهايه wchar_t) . واذا لم يكن هناك تعريف سيكون النوع TCHAR هو char عادي.
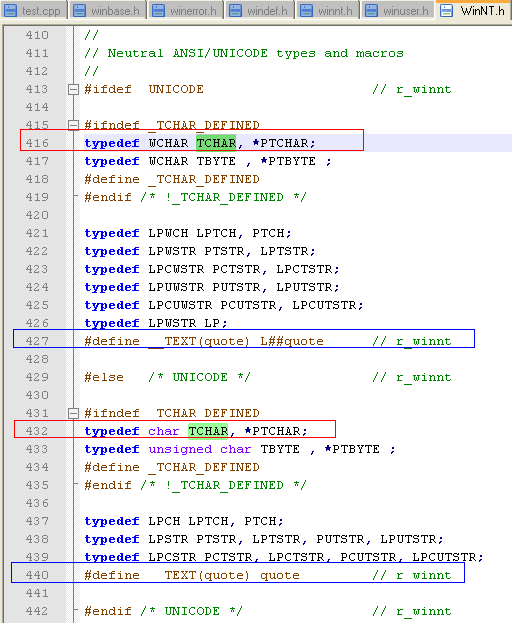
الشكل 12 يبين تحديد النوع على حسب وجود تعريف للUnicode
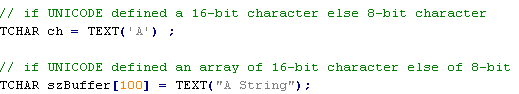
وبالتالي عند كتابة الكود التالي سنجد أن السطر الأول قد يكون حجمه 1 بايت أو 2 بايت وذلك بالإعتماد على هل الثابت UNICODE معرف في الكود أم لأ. ونفس الأمر بالنسبة للسطر التالي.
1.3.2. ANSI and Unicode Functions in Widows
منذ صدور Windows NT وكل النسخ التي تليه بنيت بدعم كامل للينوكود، وكل الدوال سواء كانت لإنشاء النوافذ أو عرض ومعالجه النصوص تتطلب نصوص بنظام يونيكود Unicode string. وفي حال قمت باستدعاء أحد تلك الدوال بنص ANSI (1 بايت لكل حرف) فسوف تقوم الدالة أولا بتحويل النص الى Unicode وبعدها تكمل العمل وعند ارجاع القيمه الراجعه وكنت تستقبلها في نص ANSI فسوف تقوم الدالة بعملية تحويل النص من اليونيكود الى الANSI وترجعه الى الدالة المستدعية. وكل من هذه التحويلات لا يعلم عنها المستخدم ولكن لها استهلاك overhead سواء في الوقت المستغرق لعملية التحويل أو الذاكرة التي تتطلبها عملية التحويل.
وأغلب دوال الويندوز والتي تتطلب string كمعامل يكون لها نسختين الأولى للتعامل مع الANSI String وتنتهي هذه الدوال بA والنسخ الثانية للتعامل مع الUnicode وتنتهي هذه الدوال بW (نسبة لWide Character) . مثال الدالة CreateWindowEx هي ليست دالة في الحقيقة بل ماكروا سيتم عمل تحويل expand له الى النسخه ANSI (CreateWindowExA) في حال كان لا يوجد تعريف للUNICODE أما اذا كان هناك تعريف للUNICODE سيتم تحويل الماكروا (قبل البدء بالترجمه بواسطة الPreprocessor ) الى النسخه CreateWindowExW .
الكود التالي من ملف الرأس WinUser.h وهو يحتوي على تصاريح الدالتين CreateWindow(Ex) ويبين كيفية الexpand في حال كان هناك معرف لليونيكود:
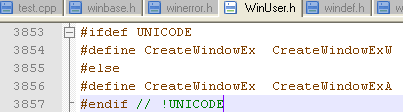
الشكل 13 يبين اختلاف الدالة على حسب تعريف الماكروا UNICODE
في نظام Windows Vista نجد دوال الANSI والتي تتنهي بA هي مجرد طبقة للتحويل حيث تقوم بتحويل النص من ANSI الى Unicode ثم تقوم باستدعاء النسخه Unicode من الدالة وترسل لها النص وعندما تعود الدالة الUnicode الى النسخه ANSI تقوم الأخيره بتحويل النص الANSI وترجعه للتطبيق. وبهذه الطريقة سوف تجعل التطبيق أكثر استهلاكا للذاكرة وأكثر بطئا في العمل. لذلك استخدام الUnicode يجعل التطبيق أكثر كفائه.
في حال كنت تطور ملف dll يمكنك ان تزود ملف الDll بدالتين للتصدير الأول تدعم ANSI والأخرى Unicode وتقوم الأولى بعملية التحويل لليونيكود واستدعاء نسخه الUnicode كما في نظام vista بالضبط.
بعض الدوال في Win32 API مثل OpenFile و WinExec ما زالت تعمل كنوع من التوافق مع التطبيقات القديمه Backward Compability وهي تستقبل ANSI String فقط. وهذه الدوال يجب تجنبها واستخدام CreateProcess بدلا من WinExec واستخدام CreateFile بدلا من OpenFile. وعلى أيه حال هذه الدوال القديمه تستدعي تلك الدوال الجديدة من الداخل ولكن المشكلة في أنها لا تستقبل Unicode. وحاليا بدأت مايكروسوفت بعمل دوال تستقبل Unicode فقط مثلا الدالة ReadDirectoryChangeW.
عند ترجمه ملف الresource (والذي يحتوي على قالب الDialog والصور والنصوص في واجهه التطبيق) باستخدام مترجم الresource فسوف يقوم المترجم بتحويل النصوص الى Unicode مباشره.
1.3.3. ANSI and Unicode Functions in C Run-Time Library:
كما في دوال نظام الويندوز Win32 API نجد أن مكتبة لغه السي القياسية تحتوي على دوال تتعامل مع الANSI ودوال تتعامل مع الUnicode ولكن تفرق مكتبة السي عن دوال الويندوز في أن نسخ الANSI لا تستدعي نسخ الUnicode بل تقوم بالعمل بمفردها وبنفس الأمر دوال الUnicode تقوم بكل العمل ولا تستدعي نسخه الANSI .
مثلا الدالة strlen وهي نسخه ANSI و ترجع طول النص ANSI string أما الدالة wcslen في نسخه Unicode وترجع طول الUnicode string وكل من هذه الدالتين مصرحات في ملف الرأس String.h . ولكتابة برنامج يترجم عام يترجم الى ANSI أو الى Unicode يجب أستخدام الماكروا _tcslen وهو موجود في ملف الرأس TChar.h والذي يتم عمل expand له الى wcslen في حال كان هناك تعريف لل _UNCODE والا سيتم تحويله الى strlen .
1.3.4. Secure String Functions in C Run-Time Library:
الدوال التي تتعامل مع النصوص يجب أن تكتب بعنايه وخاصه تلك الدوال التي تقوم بنقل أو نسخ النصوص من مكان لأخر ، ففي حال كان المكان الذي سننقل اليه النص destination Buffer ليس كبيرا كفاية لإستقبال النص سوف تحدث مشكلة بالذاكرة Memory Corruption. المثال التالي يوضح ذلك :
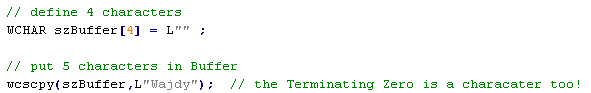
المشكلة في دالة _tcscpy بنوعيها (strcpy و wcscpy) وأيضا أغلب دوال التعامل مع النصوص في أنها لا تستقبل معامل يحدد لنا طول الDestination Buffer وبالتالي فإن الدالة لن تعلم بأن هناك مشكلة ولن تظهر أي رسالة تدل على خطأ وهكذا لن يعلم المستخدم بأن هناك مشكلة في الذاكرة. ومن الأفضل أن لا تعمل الدالة على أن تعمل وتحدث مشكلة قد تؤدي لحدوث مشاكل أخرى فيما بعد.
استغلت الMalware هذا النوع من الأخطاء بشكل كبير في الماضي ، لذلك قدمت مايكروسوفت مجموعه جديدة من الدوال الأمنه تقوم بنفس وظائف تلك الدوال ولكن مع اضافة التحقق من حجم الBuffer وهل هو مساوي للSource String . وهذه الدوال مصرحه عنها في ملف الرأس StrSafe.h . وقامت مايكروسوفت بتعديل مكتبة MFC و ATL وجعلها تتعامل مع هذه الدوال الأمنه وبالتالى اعادة بناء Rebuilding تطبيق MFC قديم بأحد الإصدارات الجديدة كافي للتخلص من مشاكل التعامل مع الدوال غير الأمنه.
وعند تضمين ملف الرأس StrSafe.h في البرنامج (والذي يحتوي على تضمين ملف String.h ) وأستخدام دوال السي غير الأمنه مثل _tcscpy فسوف تخرج أخطاء عند الترجمة . كما يوضح ذلك المثال التالي :
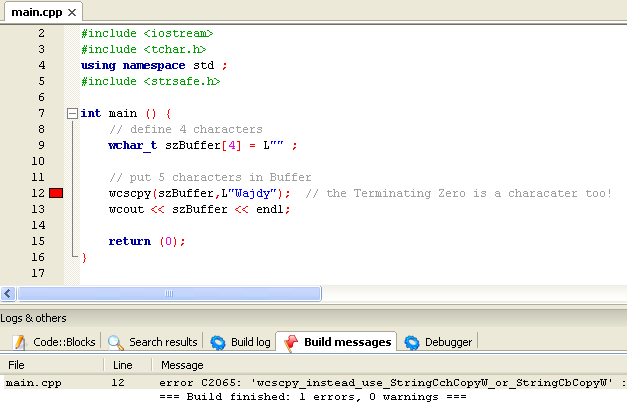
الشكل 14 يبين مثال لإستخدام الدوال غير الأمنه
اذا قمنا بالنظر الى ملف StrSafe.h سنجد أن هناك أسطر توضح انه اذا تم استخدام أي من تلك الدوال القديمه سيخرج لنا الخطأ المناسب والذي يحدد لنا الدالة الأمنه (من ملف StrSafe.h) المقابلة لها :

الشكل 15 يبين الدالة الأمنه المقابلة للدالة غير الأمنه في الملف StrSafe.h
وفي مترجمات مايكروسوفت الجديده وحتى ولم نصرح عن StrSafe.h سنجد بأن هناك تحذير ينبهنا الى عدم استخدام تلك الدوال ، ويفضل التعامل مع تلك التحذيرات بجدية واستبدال الدوال غير الأمنه بنظيراتها الأمنه.

الشكل 16 يبين التحذير الذي يخرج عند استدعاء الدوال غير الأمنه
ولكل دالة في دوال مكتبة السي مثل _tcscpy و _tcscat ما يقابلها في الدوال الجديدة وله نفس الإسم ولكن ينتهي بعلامه _s وكل من هذه الدوال الجديدة اضافت معامل يوضح عدد الحروف في الBuffer والتي تستقبل النص. التصريح التالي للدالة الأمنه _tcscpy_s ونلاحظ أن هناك معامل واحد زياده عن الدالة الأصليه _tcscpy .
التصريح للنسخه ANSI :
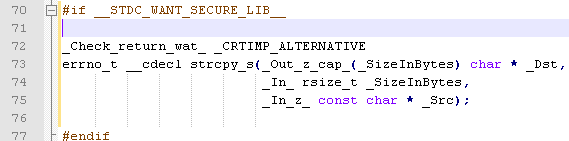
الشكل 17 يبين تصريح الدالة strcpy_s (النسخه ANSI ) .
وهذا التصريح للنسخه Unicode :
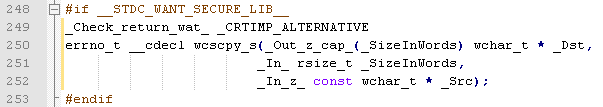
الشكل 18 يبين تصريح الدالة strcpy_s (النسخه UNICODE ) .
لاحظ أن هذه الدوال تستقبل عدد الأحرف وليس عدد البايتات (والتي تخرجها الدالة sizeof ) ويتم استخراج عدد الأحرف بقسم حجم المصفوفه على حجم العنصر الأول منها أو باستخدام الماكروا _countof الموجود في stdlib.h (لا يوجد في GCC) .
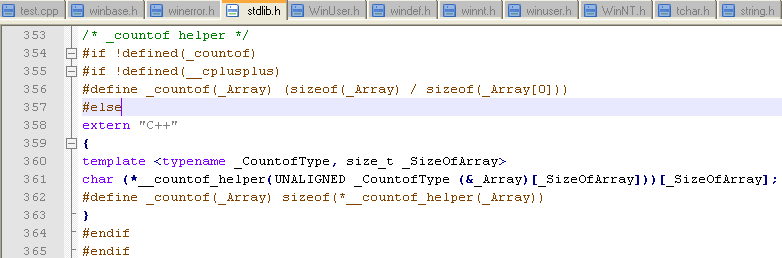
الشكل 19 يبين تعريف الماكروا _countof في مترجم مايكروسوفت
كل الدوال الأمنه والتي تنتهي بعلامه (_s) تتحقق من جميع المعاملات قبل أن تبدأ بالعمل ، حيث تقوم بالتأكد من المؤشر (أول معامل) صحيح ولا يؤشر لNULL ويتأكد من أن المعامل الثاني (عدد الأحرف) هو عدد صحيح integer ، وتتأكد من المعامل الثالث بأنها صحيحه وأن الBuffer حجمه كبير كفاية لنقل المعامل الثالث اليه.
وفي حال حدثت مشكلة أثناء أحدى هذه الفحوصات فتضع الدالة خطأ errno وترجع في كلا الأحوال errno_t وهي قيمه تدل على النجاح (S_OK) أو الفشل (أي قيمه أخرى مثل EINVAL ومعناها أن المؤشر يؤشر لNULL ، بقية الأخطاء توجد في ملف الرأس errno.h ). وفي الحقيقة هذه الدالة عند الخطأ لا ترجع قيمه وإنما بدلا من ذلك (عند العمل في طور الdebug) تقوم باخراج رسالة للمستخدم عن المشكلة ويتم انهاء التطبيق . أما في طور النسخه النهائية Release فيتم انهاء التطبيق مباشره بلا أي رسالة . المثال التالي ينقل نص أكبر من الBuffer باستخدام الدالة الأمنه وبما أن التطبيق يعمل في Debug mode فسوف تخرج الرسالة التاليه وهيUnfriendly بكل تأكيد.
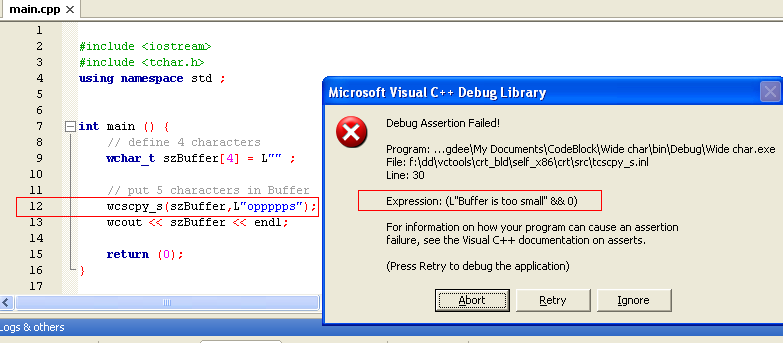
الشكل 20 يبين اكتشاف خطأ BOF عند استخدام الداول الأمنه
وعند تنفيذ المثال التالي:
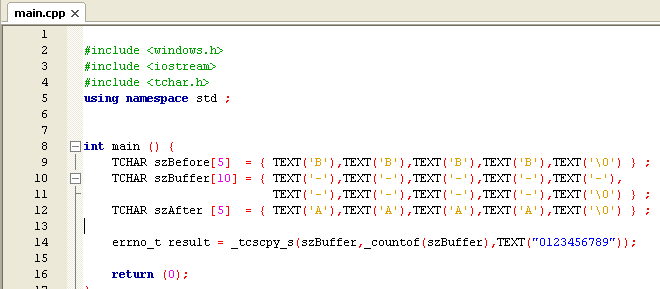
الشكل 21 يبين مثال على استخدام الدوال الأمنه
سوف يحصل نفس الخطأ السابق ويتم انهاء التطبيق ، وسوف تكون قيمه szBuffer بعد الدالة هي NULL والسبب أن هذه الدوال الأمنه والتي تنتهي ب _s لا تقوم بعمل تخزين النتيجة المناسبة وترك الباقي بل تضع NULL في حال الخطأ.
وأضافت مايكروسوفت للC Run-Time Library العديد من الدوال الجديدة والتي تعطي تحكم أكثر عن التعامل مع النصوص مثلا التحكم بالحروف التي ستملاء الBuffer عند حدوث الoverrun وكيف يطبق الTruncation .
من هذه الدوال StringCchCopy(Ex) و StringCchCat(Ex) و StringCchPrintf(Ex) وغيرها الكثير من الدوال وهي مصرحه في ملف الرأس StrSafe.h . الشكل التالي يبين تعريف الدالة StringCchCopy(نسخه الANSI):

الشكل 22 يبين تعريف الدالة StringCchCopyA
لاحظ الأحرف Cch في هذه الدوال والتي هي اختصار ل Count of Character ويتم الحصول عليها باستخدام _countof .أيضا هناك دوال لها Cb مثل StringCbCopy و StringCbCat وغيرها والتي تعني Count of Byte ويتم الحصول عليها بواسطة sizeof. كل من هذه الدوال ترجع HRESULT والجدول التالي يبين القيم الراجعه:
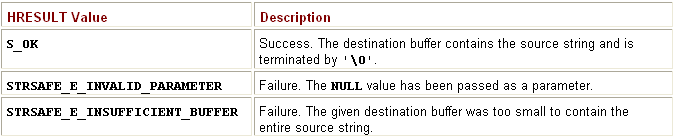
الشكل 23 يبين القيم الراجعه من الدوال StringC**
وبعكس الدوال الأمنه والتي تنتهي ب _s فهذه الدوال تقوم بقطع القيم الزائده Truncation عندما يكون الBuffer صغيرا وتنقل ما تستطيع نقله بالإضافة الى علامه ال\0 وتستطيع معرفه هذا الوضع عندما تكون القيمه الراجعه هي INFUICEINT_BUFFER . وفي حال طبقنا المثال السابق (نقل الأرقام 0123456789 الى Buffer) باستخدام الدالة StringCchCopy فسوف تكون محتوى الBuffer هو 012345678 .
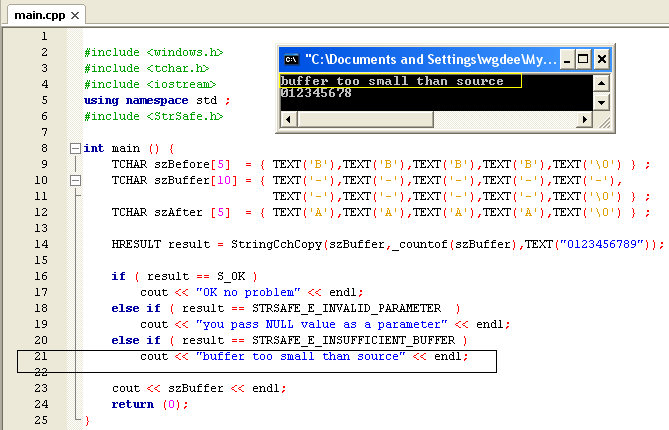
الشكل 24 يبين استخدام الدالة StringCchCopy
لاحظ أن خاصية الTruncation قد تكون مطلوبه في أحدى الأحيان وأحيانا غير ذلك لذلك على المبرمج استخدام هذه الدوال عندما يريد هذه الخاصية. بعض الدوال تنتهي ب (Ex) ولها المعاملات والقيم الراجعه التالية:
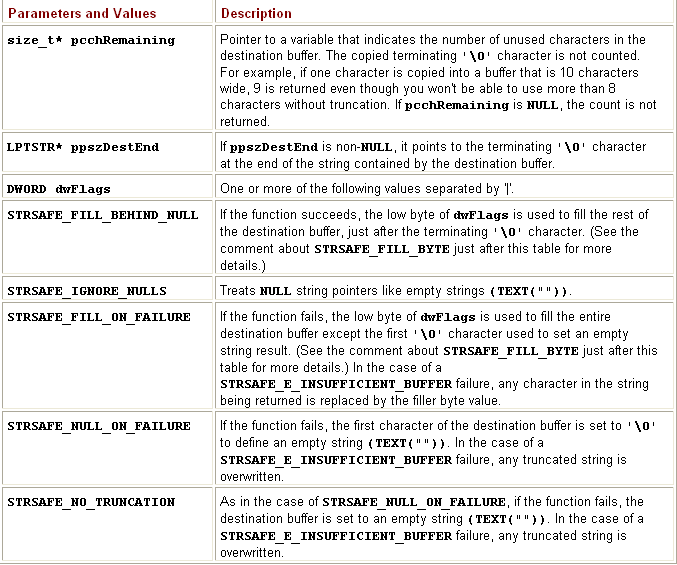
الشكل 25 بين المعاملات المرسلة والقيم الراجعه للدوال الأمنه
1.3.5. Windows String Functions:
أيضا قدم نظام ويندوز العديد من الدوال لمعالجة النصوص ولكن البعض منها لا يفضل استخدامه لأنها لا تحتوي على تحقق من حجم الBuffer وتعتبر ملغية Deprecated خاصه دوال الكيرنل lstrcpy و lstrcat . أيضا قدم ويندوز العديد من دوال معالجة النصوص المفيده في ملف الشل ShlwApi.h .
بالنسبة لمقارنه النصوص فتوجد الدالتين CompareString(Ex) و CompareStringOrdinal ، وتوجد الدالتين في ملف WinNls.h وتصريح الدالة الأولى CompareString كما يلي (نسخه الANSI ) :
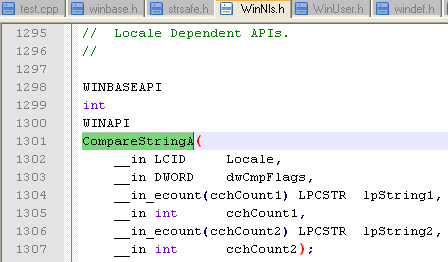
الشكل 26 يبين تصريح الدالة CompareStringA
لاحظ أن هذه الدالة تستقبل معامل يحدد معرف اللغه ويمكن الحصول عليه باستخدام الدالة GetThreadLocale وترجع هذ الدالة قيمه LCID.والمعامل الثاني يحدد الFlags المستخدم والجدول التالي يوضح هذه الFlags
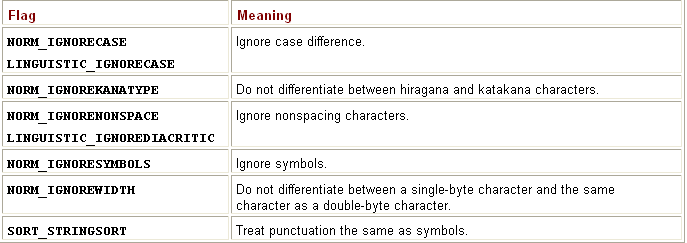
الشكل 27 يبين الFlag للدالة CompareStringA
أما بقية المعاملات فهي لتحديد النصين وعدد الأحرف لهذين النصين ، واذا تم ارسال قيمه سالبة لعدد الأحرف (سواء ccCount1 أو cchCount2) ستقوم الدالة بحساب طول النص بنفسها.
أما الدالة الثانية وهي لعمل مقارنه ولكن بدون النظر للLocale كما في الدالة الأولى والتي تستقبله كمعامل. وتصريح الدالة CompareStringOrdinal كالتالي:
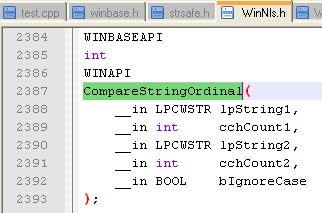
الشكل 28 يبين تصريح الدالة CompareStringOrdinal
وتقوم بعمل مقارنه بدون النظر للLocale وبالتالي فهي أسرع في العمل ويفضل استخدامها عند مقارنه النصوص العادي(مثل المسارات Path و قيم الRegistry وغيرها) .
وترجع هذين الدالتين قيمه مختلفه عن القيم الناتجة من دوال المقارنه في لغه السي حيث ترجع هذه الدوال القيمه 0 في حال الفشل والقيمه 1 ( CSTR_LESS_THAN) في حال كان النص الأول lpString1 أقل من الثاني، وترجع 3 (CSTR_GREATER_THAN) في حال كان النص الأول lpString1 أكبر من الثاني ،وترجع 2 (CSTR_EQUAL) في حال التساوي.
ولجعل ناتج هذه الدوال مشابه لدوال المقارنه في لغه السي يمكن (في حال نجاح الدالة) أن نطرح من القيمه الناتجه 2 وبالتالي يكون الناتج 0 في حال التساوي و1 في حال النص الأول أكبر و-1 في حال كان النص الأول أصغر.
1.3.6. لماذا يجب أستخدام اليونيكود Why You Should Use Unicode:
يفضل عند تطوير التطبيقات استخدام ال Unicode لأنه يجعل عملية الLocalization سهله وبالتالي يكون هناك ملف exe أو dll واحد يدعم كل اللغات. بالإضافة الى أن استخدام الUnicode يجعل التطبيق أكثر كفائه ويستهلك ذاكرة أقل. وأيضا يكون متوافق مع مخرجات مترجم الResource بالإضافة الى العمل على .NET و COM والتي تدعمان الUnicode بالكامل.
وذلك يفضل تحويل التطبيقات وجعلها جاهزه للUnicode وحتى لو لم تكن هناك نية لاستخدام الUnicode في الوقت الحالي ، ويمكن أتباع ما يلي:
• استخدام أنواع البيانات العامه Generic Data Type مثل TCHAR و PTSTR.
• استخدام الماكروا _T أو TEXT لأي نصوص Literal String في البرنامج .
• الدوال التي تستقبل عدد الأحرف نرسل لها _countof أما التي تستقبل عدد البايتات نرسل لها sizeof . وعند إراده حجز مساحة وكان لدينا عدد الأحرف فيجب حجز مساحة تساوي عدد الأحرف مضروبا في عدد بايتات الحرف الواحد ، كما يوضح الشكل التالي:

الشكل 29 يحدد كيف يمكن حجز مساحة بطول النص بطريقة صحيحه
• تجاهل استخدام عائلة printf بالكامل وخصوصا التي تستخدم %s و %S للتحويل من الANSI الى الUnicode والعكس ، ويتم استخدام الدوال MultiByteToWideChar و WideCharToMultiByte .
• دائما يتم تحديد المعرفين UNICODE و _UNICODE (الأثنين معا أو بدونهم).
• عند معالجة النصوص يجب استخدام الدوال الأمنه والتي تنتهي ب _s واذا كان المبرمج يريد قطع النتيجة فيستخدم دوال StringCch* .
• لا تستخدم دوال الكيرنل lstrcpy , lstrcat .
نتوقف هنا ، ونكمل المره القادمة في موضوع الKernel Object .
أي سؤال/استفسار/خطأ/اضافة يرحب بها ...
واذا أسلوب الشرح غير جيد فأرجوا اخباري ،، ليس لأتوقف بل لأغير الطريقة :wink: ..
المرجع الأساسي:
Windows via C/C++ by Jeffrey Richter and Christophe Nasarre
Windows System Programming by Johnson M. Hart
ً
والسلام عليكم ورحمه الله وبركاته ،