الفريق العربي للبرمجةأرشيف المنتديات · 2000 – 2023
نسخة أرشيفية للقراءة فقط — التسجيل والمشاركة مغلقان، والمحتوى محفوظ كما كان.

ال Character Encoding

بدأه ahmadarafa في 30 أغسطس 2009 · 3 رد · 842 مشاهدة · في الأسئلة المجابة
مشاركة: واتساب X فيسبوك تيليجرام
#1 صاحب الموضوع

السلام علكم ورحمة الله وبركاته

أعتذر إن كان هذا الموضوع ليس فى مكانه الصحيح 

أريد أن أعلم ماهو الcahracter encoding 

بالإضافة مالفرق بين

هذه الرموذ

1-  0x8f

2- \Xcb

3-\u064A

4-%D8%A3

سؤال أخير مالفرق بين الunicode و الUTF-8 ?

أسف إن كان موضوعى لايتناسب مع القسم 

شكراً
تم تعديل هذه المشاركة بواسطة ahmadarafa في 30 أغسطس 2009 في 04:57

#2

وعليكــم السـلام ورحمة الله وبركاتـه..

يقصد بCharacter Encoding هو إعطاء أي حرف في الأبجدية رقم معين ، وبالتالي من خلال هذا الرقم يتم الوصول للحرف وهذا يسهل من عملية ارسالة البيانات وتخزينها Sending and Storage . ومن أوائل التراميز هو مورس كود Morse Code وتم اسناد لكل حرف صوت أو Pluses معينة .

أيضا ترميز ASCII هو أحد الencoding ويتم تمثيل أي حرف من خلال 7 بت ، ولكن هذا الترميز غير كافي لتمثيل جميع أحرف اللغات الأخرى مثل العربية والصينية وغيرها ،،

أخيرا طور الUnicode لتلافي هذا القصور ويوجد عدة encoding في الينوكود (UTF-8 , UTF-16 , UTF-32) كل منها ترمز الأحرف بعدد من البتات كما يوضح اسم الترميز . (UTF-32 يرمز أي حرف من خلال 4 بايت) .

بالنسبة للرموز التي وضعتها فأول 2 اثنين هي قيم بالنظام السادس عشر Hex والثالثه تستخدم u للإشاره بأنه حرف ينوكود والأخير لا أعرفه ..

للمزيد من هذا الموضوع

اقتباس
1.3. Working with Characters and Strings:

بما أن نظام الويندوز يعد من أكثر الأنظمه انتشاراً حول العالم ويدعم أغلب اللغات المعروفة فيجب على المبرمجين كتابة برامج تدعم تلك اللغات لكي ينتشر التطبيق بشكل كبير في International Market. في السابق كان المبرمجين يكتبوا التطبيق باللغه الإنجليزية ثم يتم طرح دعم اللغات المختلفه مع الإصدارات التالية للبرنامج. وبالإستفادة من دعم النظام لأغلب اللغات فيمكن من البدايه كتابة البرنامج وجعله يدعم تلك اللغات المختلفة.

ومن المواضيع المهمه للغايه عند التعامل مع العمليات على النصوص هو تجنب الثغرات Buffer Overrun والتي تكون عادة عند التعامل مع النصوص. وأولت مايكروسوفت إهتماماً لهذا الأمر وقدمت مجموعه جديده من الدوال الأمنه والتي عند استخدامها ستحمي التطبيق من هذه الثغرات كما سيتبين ذلك لاحقاً.

المشكلة الحقيقية في موضوع الLocalization هو التعامل مع أبجديات مختلفة Character Sets ففي لغه السي نجد أن حجم المتغير من النوع char يبلغ واحد بايت (8 بت) وهو كافي لتمثيل جميع الحروف اللاتينية ولكن بعض اللغات مثل اليابانية تحتوي على الكثير من الأحرف في الأبجدية وهنا لن يكفى بايت واحد لمثيل كل هذه الحروف. ولحل هذه المشكلة تم تطوير أبجدية Double-Byte Character Sets (DBCS) وهي تمثل الحرف ببايت وحد أو 2 بايت. ففي اللغه اليابانية Kanji اذا كان الحرف الأول يقع في المدى من 0x81 الى 0x9F أو من المدى 0xE0 الى 0xFC فيجب النظر للبايت التالي لمعرفه الحرف (حيث يكون مكون من بايتين). والتعامل مع هذه النظام DBCS كان غير مريح للمبرمجين حيث بعض الأحرف تكون بحجم واحد بايت والأخرى بحجم 2 بايت ومن هنا كانت ولادة النظام اليونيكود Unicode (في عام 1988 بواسطة Apple و Xerox وبعدها انضمت بقية الشركات الكبرى في دعم هذا المقياس وتطويره مثل Oracle, IBM, Microsoft وغيرهم).

ونظام الويندوز يدعم اليونيكود سواء في داول الويندوز Win32 API أو في دوال مكتبة السي القياسية C Run-Time Library. ويستخدم النظام الترميز UTF-16 (وهو اختصار لUnicode Transformation Format) وهذا النظام UTF-16 يرمز كل حرف من خلال بايتين (16 بت) وهو كافي لمتثيل أغلب لغات العالم وبالتالي يسهل التعامل مع النصوص وحساب طولها عند العمل بهذا الترميز.

هناك ترميزات مختلفة من الUnicode منها الUTF-8 وهو يرمز الحرف الواحد بواحد أو 2 أو 3 أو 4 بايت! فالحروف التي هي أصغر من 0x0080 ترمز بواحد بايت (مثل أحرف اللغه الإنجليزي) والأحرف من 0x0080 الى 0x07FF ترمز ب2 بايت (مثل اللغات الأوروبية ولغات الشرق الأوسط Middle East) والأحرف من 0x0080 وما فوق ترمز ب3 بايت (مثل لغات الEast Asian) . وبعض الرموز ترمز من خلال 4 بايت. وبشكل عام نظام الUTF-8 استخدم كثيرا في السابق ولكنه أقل كفائه منUTF-16 في حال تم التعامل مع أحرف أكبر من 0x0080.

ترميز أخر وهو الUTF-32 وهو يرمز الحرف الواحد ب4 بايت وهو بالطبع يتعامل مع أي لغه ولكنه غير كفئ لأنه يستهلك الذاكرة (فلكل حرف 4 بايت) وبالتالي لا يستخدم هذه الترميز خصوصا في عمليات الحفظ Saving أو الإرسال عبر الشبكة بل يستخدم فقط من داخل البرنامج.

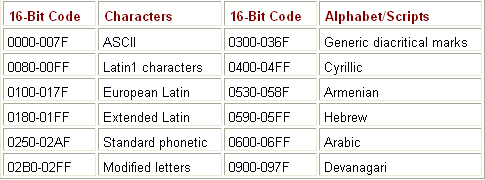
تقسم الينوكود القيم الى مناطق وكل منها تتعامل مع أبجدية مختلفة ، الجدول التالي يبين بعضا من المناطق والأبجديات المستخدمه فيها:

post-51148-1248733638.png

الشكل ‏7 يبين الأبجديات المختلفة في ترميز UTF-16

بالتوفيق :)

http://informatic-ar.com منصة تعليمية عربية في علوم الحاسب والبرمجة

https://moalfat.com  للكتب الالكترونية والكورسات التعليمية

Everything we see now is just an engineering solution based on old science

#3

شكراً لك أخى الكريم ألف شكر لك

أذن اليونيكود هو الكائن واليوتى أف هى الأصناف :)

شكراً لك مره اخرى أستاذ وجدى

#4

السلام عليكم ورحمة الله وبركاته

وجدت ماذا تعنى %D8%A3

هى URL Encoded Characters

وتأخذ % بالإضافه للقيمه الست عشريه للحرف فى اليو تى أف

فمثلاً حرف الz يصبح %7a

وحرف أ يصبح %D8%A3

http://www.degraeve.com/reference/urlencoding.php

http://www.utf8-chartable.de/unicode-utf8-table.pl

مواضيع مشابهة