الفريق العربي للبرمجةأرشيف المنتديات · 2000 – 2023
نسخة أرشيفية للقراءة فقط — التسجيل والمشاركة مغلقان، والمحتوى محفوظ كما كان.

[ تمت الإجابة ]FP-Growth Algorithm

مغلقمُجاب
بدأه سماء في 23 أكتوبر 2013 · 6 رد · 2,937 مشاهدة · في الأسئلة المجابة
مشاركة: واتساب X فيسبوك تيليجرام
#1 صاحب الموضوع

سلام
 
أريد كتابة برنامج لل FP-Growth Algorithm
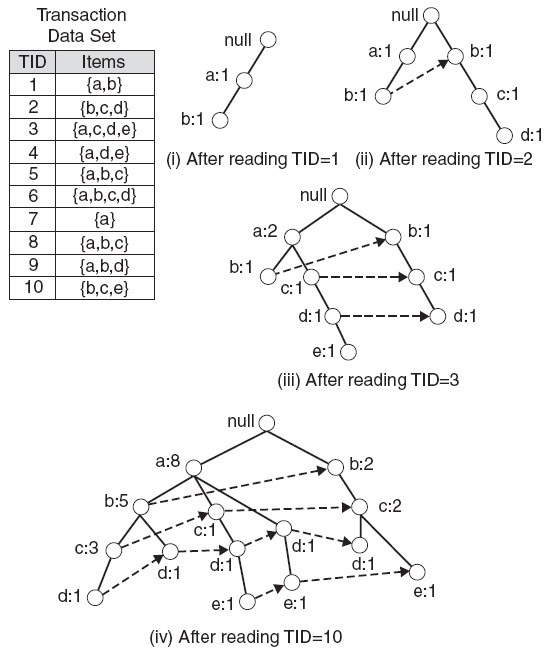
 post-278197-0-35529400-1382479319_thumb.


بحيث عند بناء الشجرة، نقوم بترتيب العناصر تلقائيا، ثم اضافة كل Transaction إلى الشجرة، بدون تكرار العناصر

بحيث أقوم بعد كل عنصر/ مثلا

a=4

b=2

-

وهكذا

وحتى الآن لا أعرف من أين أبدأ؟
مثلا:
ماهي أفضل هياكل البيانات لتمثيلها
 
 
مثال توضيحي:
 
http://csc.lsu.edu/~jianhua/FPGrowth.pdf

تم تعديل هذه المشاركة بواسطة سماء في 23 أكتوبر 2013 في 01:06

#2

السلام عليكم ..

الروابط التالية كلها تحوي سورس كود للــ FP Growth :

FPgrowth - Frequent Item Set Mining

http://www.cs.bilkent.edu.tr/~erayo/wml/code.html

http://adrem.ua.ac.be/~goethals/software/

http://www.sourcecodeprojects.com/1088516/

لا إله إلا الله ... محمد رسول الله

لو كانت مشاركتي مفيدة و تريد تشجيعي على المزيد من العطاء , فضلا قم بتقييم المشاركة

المعرًف القديم : houssam11350_11350

من مواضيعي : ArabGenCode : مولد كود و إجراءات مخزنة و واجهات لجداول سيكوال سيرفر

#3

وعليكم السلام


جزاك الله خير

#4

مستقبلا, حاولي أن تبحثي قليلا عن سؤالك قبل كتابته في موضوع جديد :)

#5
Snack3r كتب:

مستقبلا, حاولي أن تبحثي قليلا عن سؤالك قبل كتابته في موضوع جديد :)

الأخ الكريم..

سبق وبحثت عن الأكواد، بشكل "مكثف" قبل كتابة الموضوع..

وكل الروابط، التي أرفقها الأستاذ حسام (جزاه الله خير) موجوده لدي سلفا، بلغة c#, جافا، وc

وواجهت صعوبه في فهمها أما بسبب عدم خبرتي باللغات (جافا,c#) أو بسبب تعقيد البرنامج المكتوب بلغة c


وكتبت الوضوع طلبا في مساعدة من لديه معرفه بالألغورذيم

لم أذكر ذلك في ردي السابق على الأستاذ حسام لسببين :

- من باب الذوق لانسان صرف من وقته للبحث

- ولأن الموضوع بقي من غير رد، وهذا جعلني اعتقد بأن لا يوجد من سبق وتعامل مع هذا  الألغورذيم


في المرة الأخرى، كمشرف، أتمنى أن لا تستعجل الظن

وشكرا

#6 أفضل إجابة

السلام عليكم


اقتباس
كل الروابط، التي أرفقها الأستاذ حسام (جزاه الله خير) موجوده لدي سلفا، بلغة c#, جافا، وc
وواجهت صعوبه في فهمها أما بسبب عدم خبرتي باللغات (جافا,c#) أو بسبب تعقيد البرنامج المكتوب بلغة c


لا بأس, هناك متطلبات يجب عليك معرفتها من أجل فهم الخوارزمية, مثل هياكل البيانات و خصوصا الأشجار (trees).


اقتباس
لم أذكر ذلك في ردي السابق على الأستاذ حسام لسببين


أتفهم جيدا ردك لكن بطبيعة الحال, نحن هنا في المنتدى بمثابة إخوة و لاتوجد بيننا حساسيات أو ما شابه و بالتالي إذا قدم لك أحد الأعضاء (بشكل عام) مساعدة لم تؤدي إلى حل مشكلتك فيمكنك بكل بساطة أن توضحي له (و لمن يقرأ الموضوع من بعده) الأشياء التي لم تفهميها بالتحديد حتى يعلم القارئ أن الموضوع لم تتم الإجابة عليه بعد.


بالنسبة لخوارزمية FP-growth فتُدْرَسُ في مادة Data Mining و بالتحديد عند البحث عن الـ Association Rules.

FP تمثل طريقة مختلفة عن تلك التي تتبعها خوارزمية Apriori حيث تسمح باستخراج الـ itemsets المتكررة بدون توليد الـ candidates.

تقوم FP-growth (Frequent Pattern growth)l بضغط قاعدة البيانات و جعلها على شكل compact structure تُعرف باسم FP-tree, ثم تقوم بتقسيم الـ Data Base و ضعطها مجددا إلى under projections تُسمى conditional databases.

كل projection تابع لـ item متكرر, استخراج itemsets المتكررة يتم عملها في كل projection على حدة.


الهيكل الذي يُمثل FP-tree يجب أن يحتوي على عنصرين أساسيين :

  1. structure على شكل شجرة يُسمى جذرها (root) بـ null.
  2. بالإضافة إلى index (مصفوفة من الـ pointers تُشير إلى العناصر المتكررة).


بالنسبة للشجرة فتتكون من جذر يُرمز له عادة بـ null بالإضافة إلى مجموعة من العقد تبدأ من الجذر. كل عقدة يتم تمثيلها بـ :

  • Item-name : اسم العنصر.
  • Count : عدد الـ transaction التي يظهر فيها جزء من المسار (portion of path) وصولا إلى العقدة الحالية.
  • Node-link : مؤشر يُشير إلى العقدة الموالية التي تحمل نفس الـ item-name أو null إن لم توجد عقدة تحقق الشرط.


بالنسبة لـ index فهو عبارة عن جدول عناوين (header table) يحتوي على لائحة الـ items المتكررة, الجدول يخزن أو يُشير إلى أول ظهرو لكل عنصر.


الهدف من تمثيل كهذا هو معرفة الـ frequent associations التي يظهر فها العنصر المتكرر من خلال متابعة inter-nodes links.


لبناء الـ FP-Tree نتبع الخطاوت التالية :

  1. نقوم بالمرور على عناصر الـ transaction database من أجل تحديد العناصر المتكررة بدلالة الـ minimum support threshold. هذه العناصر سيتم ترتيبها لاحقا حسب support-descending.
  2. نقوم بالمرور مرة أخرى على تلك العناصر من أجل ترتيب كل transaction حسب ترتيب العناصر (items) بعد أن نقوم بإنشاء العقدة null. في نفس الوقت يتم إنشاء branching لكل transaction, جميع الـ transaction التي تملك نفس الـ prefix ستتقاسم بداية الفرع.أيضا إذا وجد two transactions متطابقتان سيتم تمثيلها في فرع واحد.


أرجو أن أكون قد أفدتك.


إذا كنت تجيدين الإنجليزية, أنصحك بقراءة المقالة التالية, ستفيدك كثيرا :

The LUCS-KDD Implementation of the FP-growth algorithm


تحياتي.

2
#7

الأستاذ الكريم..

اعتذر عن تأخري في الرد، بكل أمانه لم أقرأ ردك إلا اليوم


أولا أشكرك جزيل الشكر على الشرح، والرابط، لأنه فعلا أعاني صعوبة في التعامل مع هياكل البيانات عموما..


الأيام الماضية انشغلت ببناء الالغورذيم عن طريق محاولة تفكيك وفهم هذا البرنامج


http://xanadu.cs.sjsu.edu/~tylin/classes/cs257/2013/project/FP-Growth_C_version/fpg.c


وقد نجحت بالفعل بعمل run للبرنامج عن طريق يبعض التعديلات البسيطة على الكود بالرابط ليعمل تحت بيئة Microsoft Visual Studio 2012--> VC++--> WIN32 ConsoleApplication


وبعد ان قمت بحفظ البرنامج،  الجهاز عمل Shut down من نفسه، وعندما فتحته مرة أخرى وجدت الملف cpp للمشروع فارغ تماما من أي كود، ومع ذلك المشروع يقوم بعمل run !


حقيقة لم أفهم السبب لهذه المشكلة، لكني سأعمل من جديد بأذن الله


مرة أخرى شكرا جزيلا لك

تم تعديل هذه المشاركة بواسطة مصطفى 36a2 في 17 نوفمبر 2013 في 16:11

هذا الموضوع مغلق.

مواضيع مشابهة